ウェビナー登録件数 1595
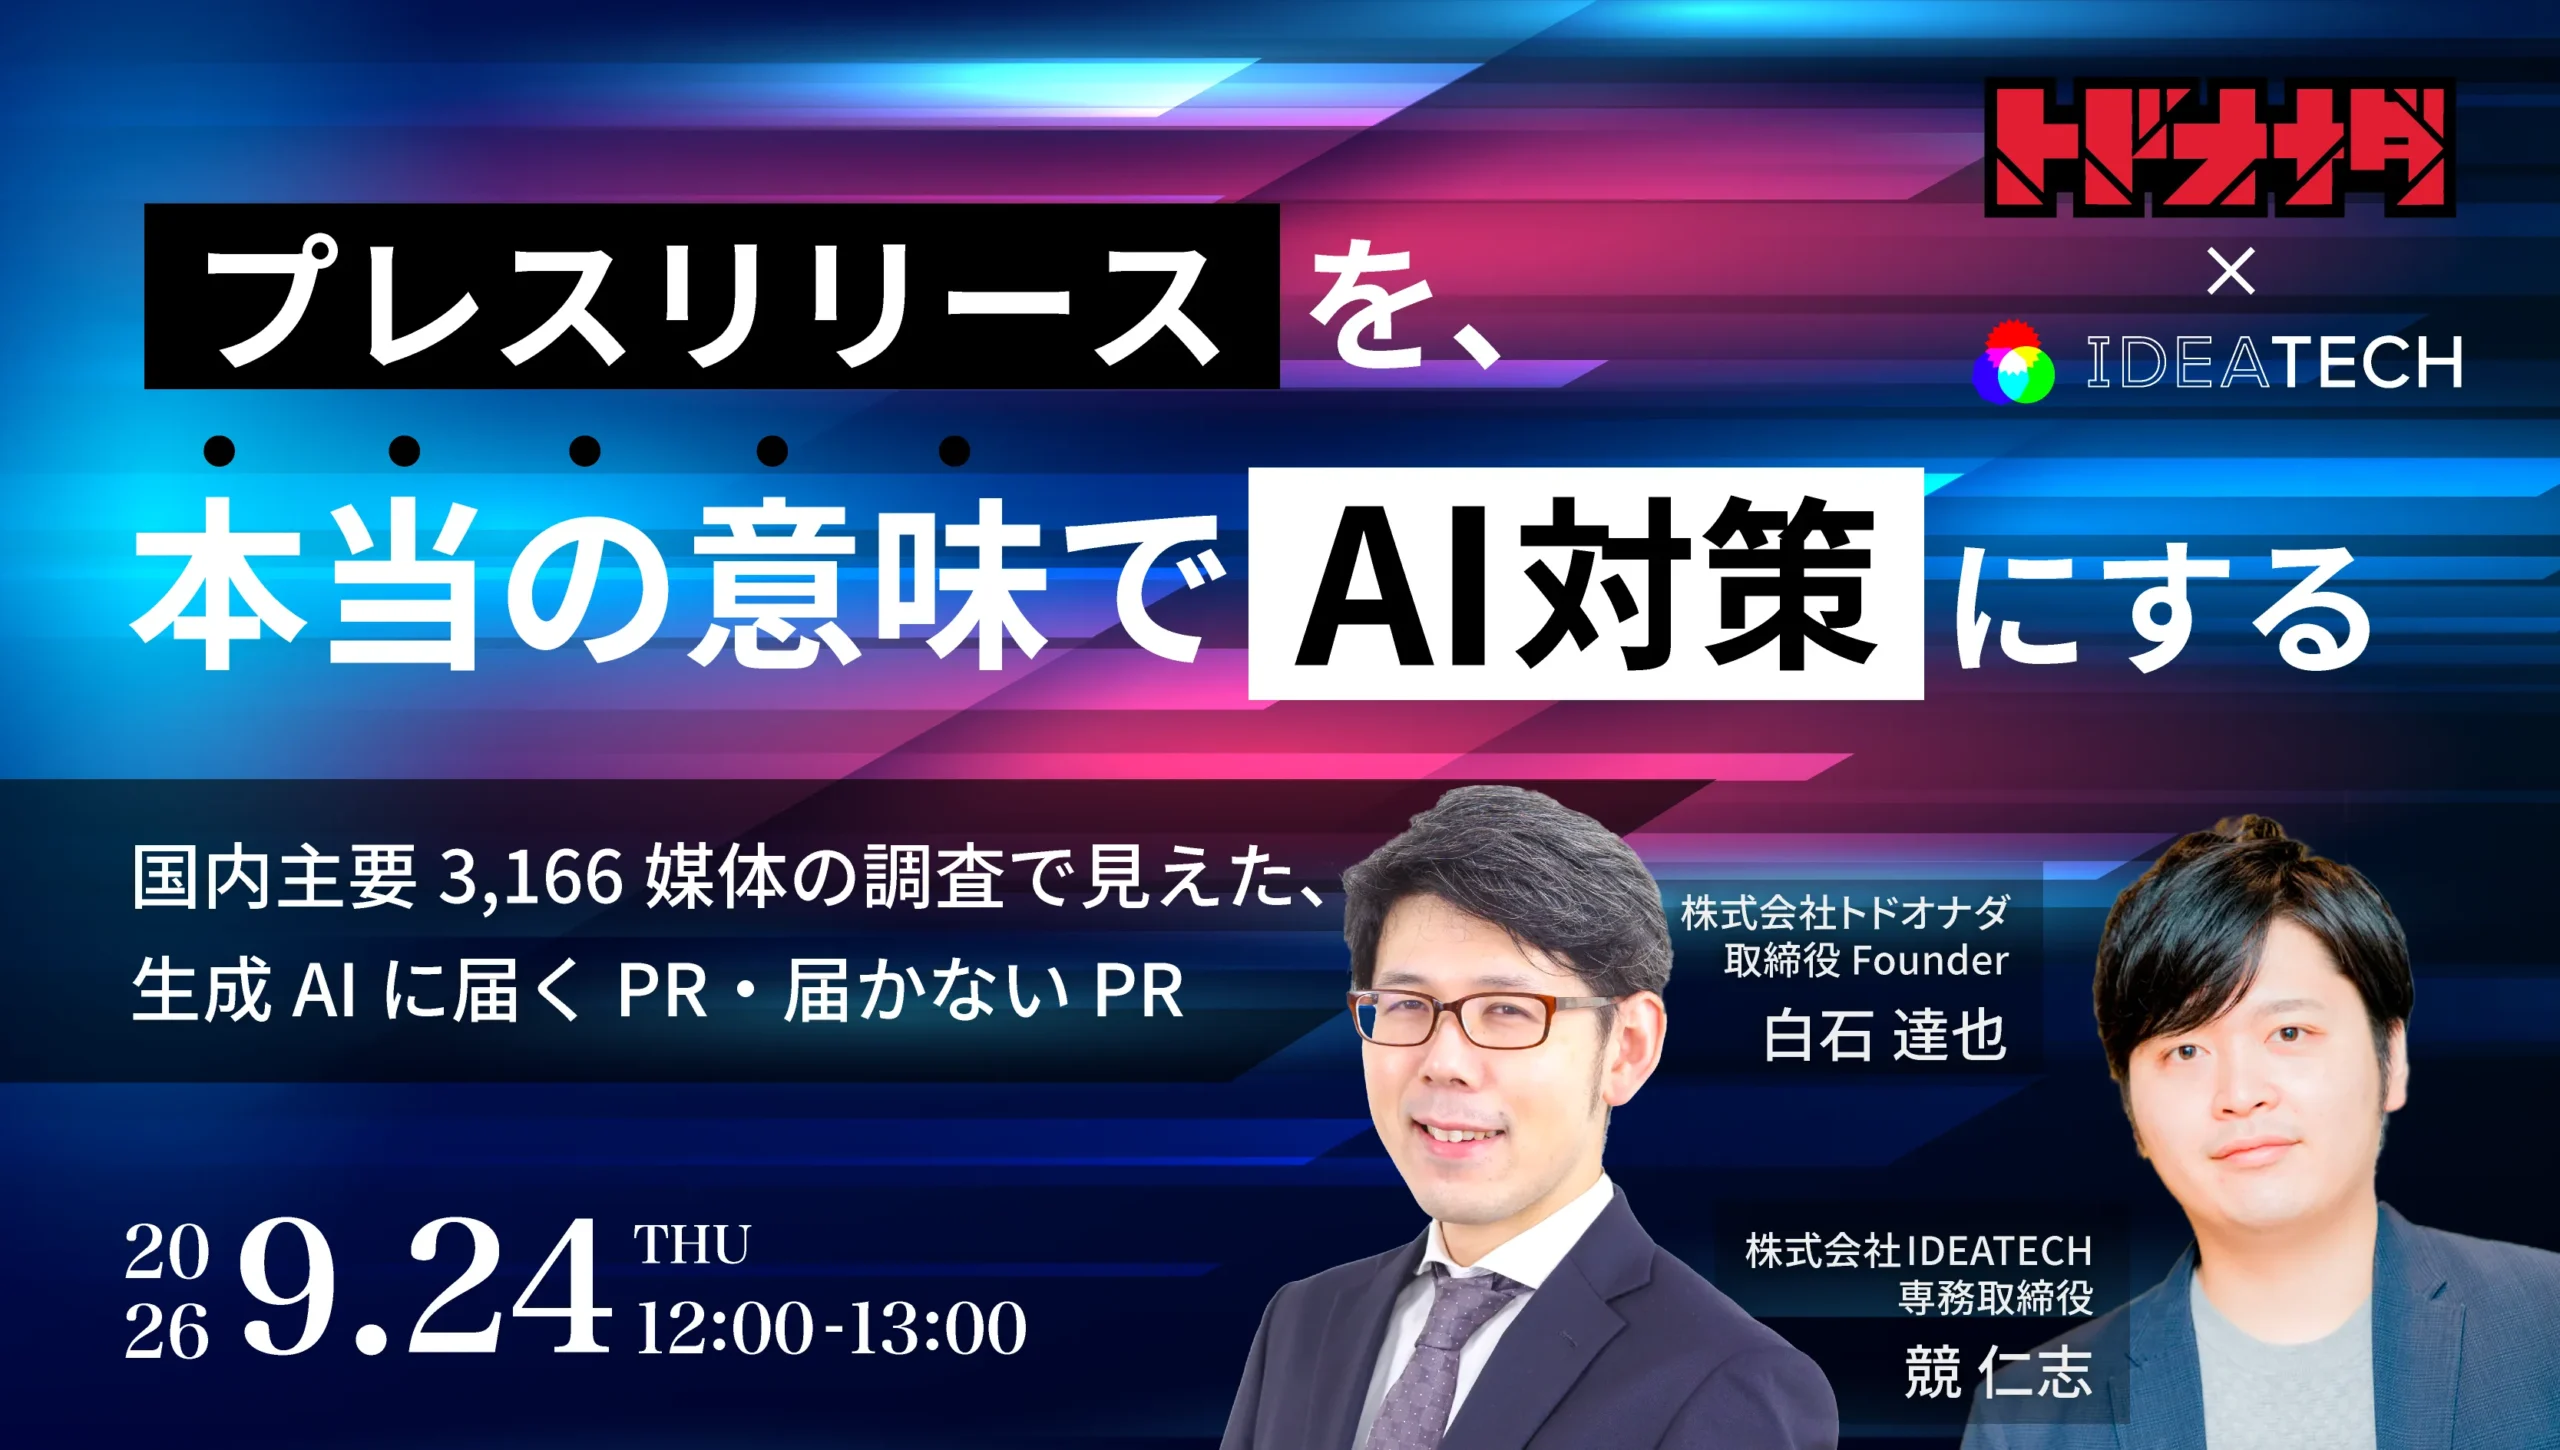
| 開催日 | 2026/09/24 |
|---|---|
| タイトル | プレスリリースを、本当の意味でAI対策にする。 国内主要3,166媒体の調査で見えた、生成AIに届くPR・届かないPR |
| 主催企業 | IDEATECH |
| 共催企業 | トドオナダ |
| URL | https://ideatech.jp/seminar/260924/ |
プレスリリースを配信し、複数のメディアに転載されれば、生成AIにも自社の情報が蓄積される。
広報やマーケティングの現場では、掲載件数を増やす施策が「AI対策」として語られ始めています。
ただし、ウェブ上に記事が存在することと、生成AIの学習材料として残ることは同じではありません。
PR効果測定サービス「Qlipper」を提供する株式会社トドオナダは、2026年6月28日、国内主要3,166媒体を対象に、生成AIの事前学習データへ届く可能性を調査しました。
主要な生成AI向けクローラーが巡回を許可されているか。記事本文を取得できるか。取得後の文章が品質基準を満たすか。
一連の工程を調べた結果、「通過見込み」と判定された媒体は317媒体、全体の10.0%でした。
10.0%
「通過見込み」と判定された媒体
317媒体/3,166媒体
33.6%
「条件付き通過」まで含めた割合
1,063媒体/3,166媒体
64.2%
本文の取り出しや品質判定の段階で、基準を満たさなかった媒体
2,032媒体/3,166媒体
3媒体
主要なプレスリリース配信サービス10媒体のうち、「通過見込み」と判定された媒体
「有名な媒体だから」「掲載件数が増えるから」という理由だけでは、生成AIへの情報到達を判断できません。
生成AIが回答する前から内部に持っている知識を形づくる仕組みを、事前学習と呼びます。
一方、質問を受けた時点で、検索結果や外部の文書を取り出して回答に使う仕組みが、検索拡張生成(Retrieval-Augmented Generation、RAG)です。
両者では、PR活動が影響する場所も、結果が表れるまでの時間も異なります。
事前学習への働きかけは、信頼できる場所に情報を長く蓄積し、将来のAIモデルが自社をどのように理解するかに関わります。
検索拡張生成への働きかけは、現在ウェブ上に存在する情報が、利用者への回答で参照される可能性に関わります。
プレスリリースやメディア掲載をAI対策として活用するには、両者を混同せず、目的に応じて発信内容と掲載先を設計しなければなりません。既存の告知案でも、事前学習と検索拡張生成では、メディア掲載の役割が異なる点を問題として挙げていました。